On parle énormément des usages que l’intelligence artificielle pourrait permettre de développer dans les entreprises : automatiser certains traitements, accélérer les analyses ou encore accompagner les métiers dans leurs prises de décision. Pour les DAF et leurs équipes, la promesse est attractive : réduire le temps consacré aux tâches manuelles pour le réallouer à des activités à plus forte valeur ajoutée. Mais comment passer de la promesse à des usages réellement opérationnels ?
C’est là que le bât blesse : l’IA remet au premier plan un problème qui existait bien avant elle, celui de la qualité de la donnée.
L’IA rend visibles les imperfections que l’humain sait compenser
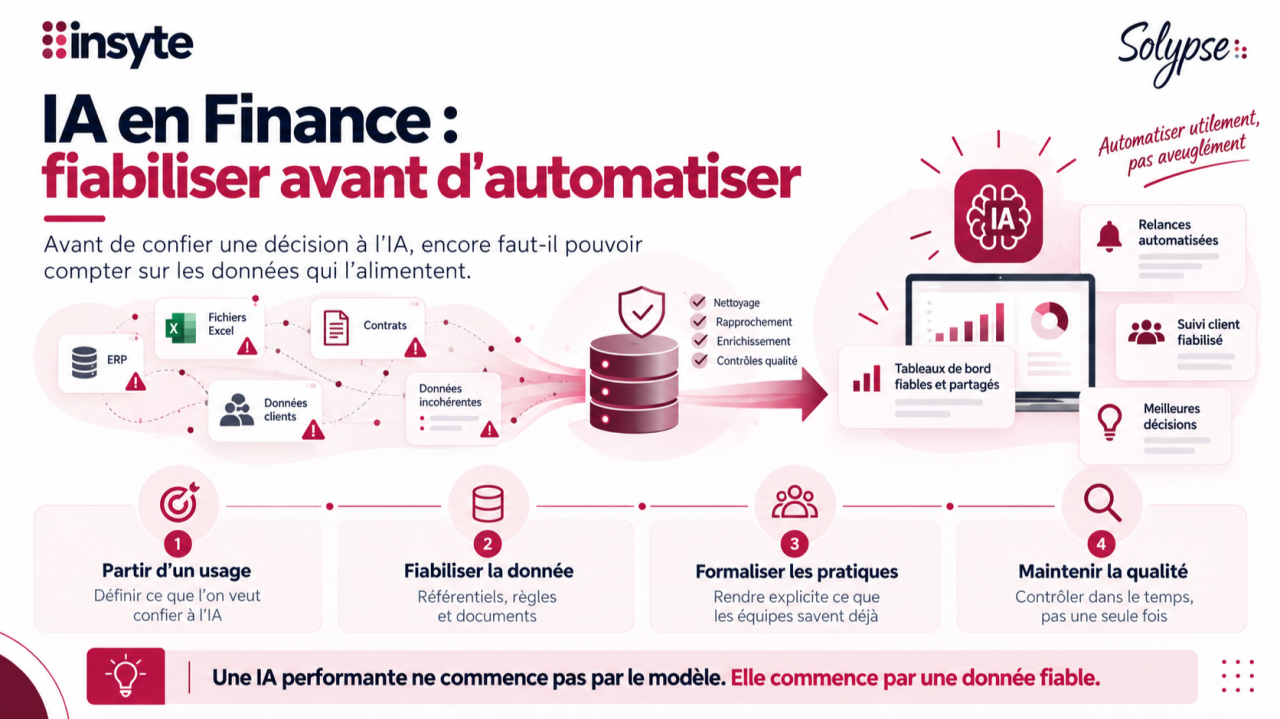
Pour automatiser un processus ou produire une analyse fiable, l’IA doit s’appuyer sur des informations suffisamment structurées, accessibles et cohérentes. Or, dans beaucoup d’organisations, les référentiels restent dispersés entre plusieurs SI, certaines informations sont dupliquées ou contradictoires et Excel permet encore de corriger, compléter ou rapprocher ce qui ne peut pas l’être directement dans les outils.
Tant que les collaborateurs restent au centre du processus, une partie de ces imperfections est absorbée par leur connaissance métier. Ils savent quelle source utiliser lorsque deux systèmes se contredisent, connaissent les cas d’exceptions, vont chercher les informations manquantes.
Préparer la donnée à l’IA, c’est rendre explicite tout ce que les équipes corrigent, interprètent et arbitrent sans l’avoir formalisé.
Partir du cas d’usage pour identifier ce dont l’IA a besoin
Prenons un cas que je rencontre chez certains de mes clients : l’automatisation des relances clients.
Aujourd’hui, plusieurs ETP sont mobilisés pour consolider les grands livres âgés de différentes sociétés, analyser les factures échues, appliquer des règles selon la typologie des tiers, identifier les promesses de paiement et calculer les pénalités. Le potentiel d’automatisation est évident.
Pour lancer ce chantier, nous avons analysé le processus de bout en bout et soulevé plusieurs questions : les référentiels clients contiennent-ils toutes les caractéristiques nécessaires ? Les contrats sont-ils accessibles et suffisamment structurés pour déterminer les conditions applicables ? Les règles de calcul sont-elles homogènes ? Les promesses de paiement sont-elles enregistrées dans un outil ou uniquement connues des équipes ? Le lettrage permet-il d’identifier avec suffisamment de fiabilité les factures réellement impayées ? La réponse est non.
À travers ce simple exemple apparaissent donc plusieurs problématiques : référentiels, transactions, documents, règles de gestion et connaissance métier. Une partie de l’information nécessaire à la décision n’existe pas encore sous une forme directement exploitable par un système.
Cela ne veut pas dire qu’il faille attendre que tout soit parfait pour lancer le projet, car une IA utilisée pour aider un chargé de recouvrement à identifier les dossiers à analyser en priorité peut tolérer certaines imperfections : le collaborateur conserve son regard critique avant toute action. En revanche, si l’objectif est d’automatiser de bout en bout l’identification des factures, le calcul des pénalités et l’envoi des relances, le niveau de fiabilité attendu devient nécessairement plus élevé.
Plus on augmente l’autonomie confiée à l’IA, plus la maîtrise des informations et des règles sur lesquelles elle s’appuie devient critique.
Formaliser ce que les équipes savent déjà
« Je sais que sur ce client, j’applique telle pénalité. », « Je ne le relance pas cette semaine, car j’ai une promesse de paiement dans dix jours. », « Il n’y a pas de contrat signé sur ce projet, mais historiquement nous appliquons cette règle. »
Ces éléments permettent aujourd’hui aux collaborateurs de prendre les bonnes décisions, alors même qu’ils peuvent être absents des systèmes d’informations.
Avant d’automatiser notre exemple, il faut donc revoir certains référentiels, harmoniser les pratiques de relance, définir les modalités de gestion des pénalités, structurer le stockage des contrats et améliorer certains traitements amont comme le lettrage.
Cela nécessite de faire travailler ensemble le recouvrement, les ADV, la comptabilité client, les opérationnels, la Finance, le juridique ou encore les équipes SI.
Un projet IA devient alors également un projet de processus et de gouvernance.
« Plus on augmente l’autonomie confiée à l’IA, plus la maîtrise des informations et des règles sur lesquelles elle s’appuie devient critique. »
La fiabilité doit être maintenue dans le temps
Un grand nettoyage avant le lancement ne suffit pas. De nouveaux clients seront créés, les contrats évolueront, les pratiques changeront et de nouveaux utilisateurs interviendront.
L’enjeu consiste donc à identifier les éléments critiques, définir leurs responsables, intégrer des contrôles au plus près de leur création et faire remonter les écarts susceptibles de compromettre les traitements automatisés. Les SI peuvent également contraindre certaines saisies, tandis que les utilisateurs doivent comprendre pourquoi certaines pratiques doivent désormais être harmonisées. L’IA peut elle-même contribuer à cette surveillance : rapprocher deux fiches clients potentiellement identiques, analyser un contrat pour en extraire une clause ou identifier une incohérence entre plusieurs sources sont des cas où elle peut apporter une réelle valeur.
Certaines anomalies pourront alors être corrigées automatiquement, tandis que d’autres seront soumises aux métiers pour arbitrage.
Partir des usages plutôt que vouloir tout nettoyer
L’arrivée de l’intelligence artificielle oblige finalement les entreprises à regarder avec davantage d’attention des difficultés qui existaient déjà et que les collaborateurs avaient appris à contourner.
Il ne s’agit pas de lancer un vaste programme de nettoyage de l’ensemble des bases disponibles mais de déterminer les usages prioritaires, comprendre les décisions et traitements que l’on souhaite confier à l’IA, puis d’identifier les informations, documents et règles dont ils dépendent. La question à se poser est de savoir ce que vous voulez confier à l’IA et sur quelles informations vous devez pouvoir compter pour la faire fonctionner.
Chez Solypse, nous intervenons sur les problématiques de nettoyage et de fiabilisation des données. En complément, au sein d’Insyte, notre practice conseil accompagne le cadrage et le pilotage des transformations SI dans lesquelles les enjeux métiers, data et technologiques doivent être pensés de concert.
À retenir
- L’IA remet au premier plan un problème plus ancien : la qualité de la donnée.
- Les équipes compensent aujourd’hui des imperfections que l’IA, elle, ne sait pas deviner.
- On part d’un cas d’usage précis pour identifier les référentiels, documents et règles dont il dépend.
- Plus l’autonomie confiée à l’IA augmente, plus la fiabilité des données devient critique.
- Formaliser la connaissance implicite des équipes fait d’un projet IA un projet de processus et de gouvernance.
- La fiabilité se maintient dans le temps, avec des contrôles à la source et l’IA elle-même en appui.