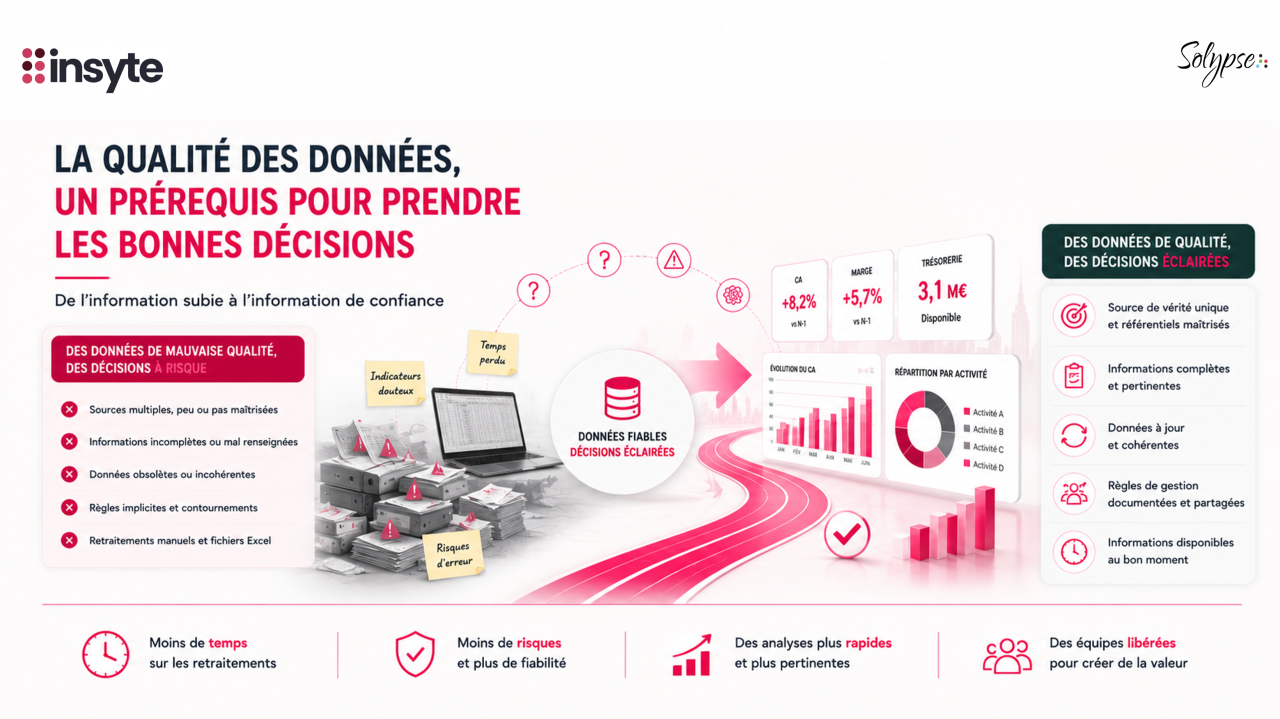
Une donnée de mauvaise qualité n’empêche généralement pas une entreprise de fonctionner. Les équipes continuent à travailler, les processus semblent fonctionner et les reportings finissent par sortir, parce que chacun s’est progressivement adapté aux dysfonctionnements.
Pourtant, cette adaptation a un coût certain : des retraitements manuels, des rapprochements sous Excel, des contrôles supplémentaires et, au bout du compte, des indicateurs dont la fiabilité est régulièrement remise en question. Les décisions continuent d’être prises, mais sur la base d’informations dont on doute de la fiabilité.
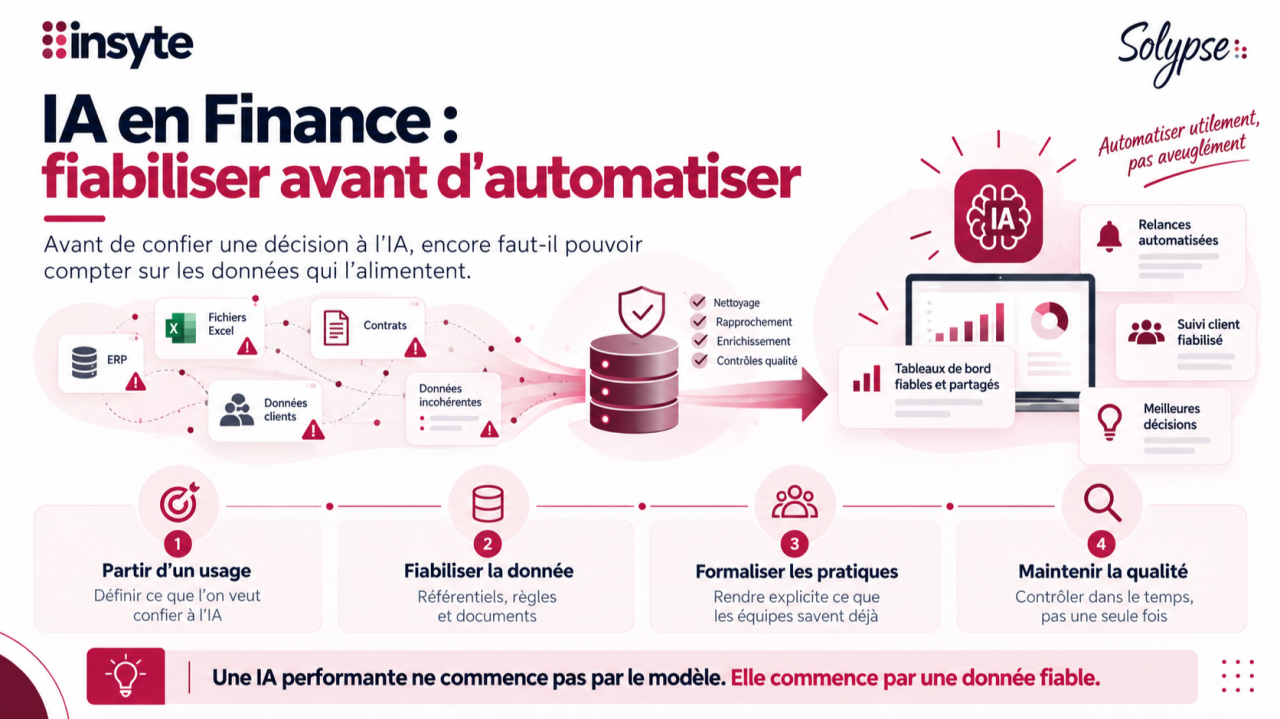
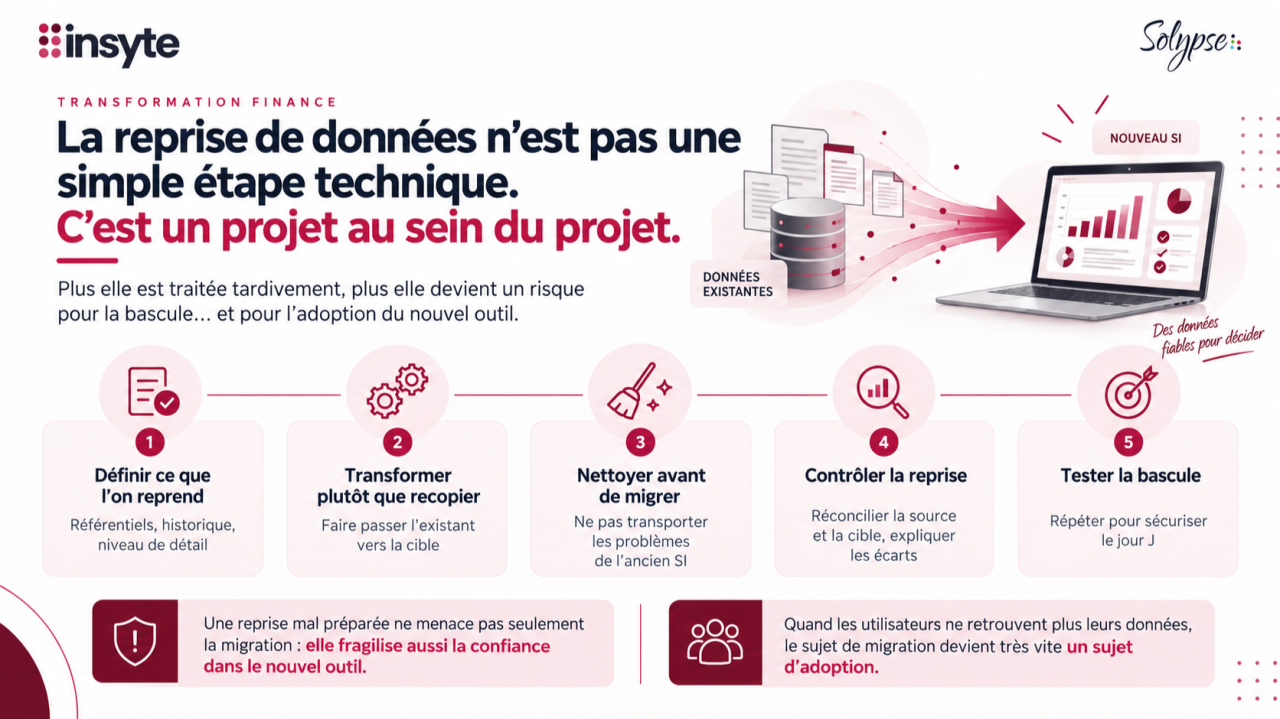
Puis vient une transformation, comme la migration vers un nouvel ERP, la mise en place de la facture électronique, l’automatisation de contrôles ou encore l’évolution des outils de pilotage. C’est généralement à ce moment-là que l’on découvre le véritable état des données de l’entreprise. Ce que l’on pensait être un chantier essentiellement technique devient rapidement un travail de compréhension, de nettoyage et de fiabilisation. On découvre des référentiels incohérents, des valeurs historiques toujours utilisées, des informations indispensables qui n’ont jamais été renseignées ou encore des règles de gestion qui n’existent nulle part ailleurs que dans les habitudes des équipes.
Au fil de mes missions, je me retrouve face aux mêmes situations : aucun système maître clairement identifié pour des référentiels pourtant stratégiques, des attributs essentiels jamais renseignés parce qu’ils ne sont pas obligatoires ou remplis sans que les utilisateurs comprennent réellement leur utilité, des nomenclatures historiques qui continuent d’être utilisées plusieurs années après avoir été remplacées, ou encore des informations présentes dans plusieurs applications sans que l’on sache laquelle fait réellement foi.
Dans la plupart des cas, ces difficultés traduisent l’absence de règles de gouvernance clairement définies : qui crée une donnée, qui la met à jour, qui en est responsable et quelle application fait référence. Derrière l’expression « qualité des données » se cachent pourtant quelques principes très concrets.
Une source de vérité clairement identifiée
Le premier consiste à disposer d’une source de vérité clairement identifiée. Lorsqu’un même référentiel est maintenu dans plusieurs systèmes sans qu’un système maître ait été défini, les écarts apparaissent rapidement. Chaque application évolue à son rythme, les corrections ne sont pas répercutées partout et les équipes passent leur temps à réconcilier des informations qui auraient dû être identiques.
Progressivement, les fichiers Excel se multiplient, chacun développe ses propres règles de fonctionnement et une partie de la connaissance métier finit par quitter les outils pour rester uniquement dans la tête de quelques collaborateurs. Il devient alors difficile de savoir quelle information fait réellement référence.
Une complétude qui a du sens
La complétude constitue un deuxième principe essentiel. Pour autant, rendre un champ obligatoire ne suffit pas. Si les utilisateurs ne comprennent pas pourquoi un attribut est demandé ni comment il sera utilisé dans la suite du processus, ils trouveront toujours une manière de le contourner ou de le renseigner approximativement. Une donnée obligatoire n’est pas forcément une donnée pertinente.
C’est souvent dans ce contexte que se développent les détournements d’usage. Un attribut est utilisé pour stocker une information pour laquelle il n’avait jamais été prévu, simplement parce qu’aucun autre champ n’existe. Tant que les équipes connaissent les règles implicites, le système semble fonctionner. En revanche, dès qu’il faut produire un indicateur, automatiser un traitement ou faire évoluer le SI, la signification de cette information devient beaucoup plus difficile à retrouver.
Une donnée maintenue dans le temps
Une donnée de qualité est également une donnée maintenue dans le temps. Lorsqu’un attribut, un code ou une valeur de référence n’ont plus vocation à être utilisés, ils doivent rapidement disparaître ou être remappés vers les nouvelles valeurs cibles. Plus les anciennes valeurs cohabitent avec les nouvelles, plus les traitements deviennent complexes et les risques d’erreur augmentent.
Le cas le plus classique est celui d’une refonte d’un référentiel analytique. De nouveaux centres de coûts ou centres de profit sont créés, mais les anciens continuent à être utilisés pendant plusieurs mois. Sans stratégie de mapping clairement définie, les équipes maintiennent des tables de correspondance sous Excel pour réconcilier les deux référentiels. Ces solutions temporaires finissent souvent par durer bien plus longtemps que prévu et complexifient durablement l’exploitation des informations.
« Une donnée obligatoire n’est pas forcément une donnée pertinente. »
Une donnée disponible au bon moment
Enfin, une donnée doit être disponible lorsque les métiers en ont besoin. L’objectif n’est pas de rechercher systématiquement le temps réel, mais d’adapter la fréquence de mise à jour aux usages. Toutes les informations n’ont pas besoin d’être synchronisées en permanence. Chercher le temps réel partout conduit souvent à complexifier inutilement les architectures, à saturer les flux d’échange et à créer des coûts sans bénéfice réel.
Un problème de données plus que de reporting
Derrière ces différents principes, l’objectif reste toujours le même : disposer d’informations fiables, exploitables et disponibles lorsque l’entreprise en a besoin. À défaut, les équipes passent du temps à réconcilier plusieurs sources d’information, les reportings nécessitent des contrôles supplémentaires, certains indicateurs sont régulièrement remis en question et les délais de production s’allongent.
Mais le risque le plus important est ailleurs. Des décisions de gestion sont prises à partir d’informations incomplètes, incohérentes ou obsolètes. La plupart des entreprises pensent alors avoir un problème de reporting, d’automatisation ou d’ERP, alors qu’elles ont un problème de qualité de leurs données.
Chez Solypse, nous sommes convaincus que la valeur d’une donnée réside dans la confiance que l’on peut lui accorder pour piloter son activité et prendre les bonnes décisions. C’est pourquoi nous accompagnons nos clients dans l’identification des causes de la non-qualité, la définition d’une gouvernance adaptée et la mise en œuvre d’actions permettant d’améliorer durablement la fiabilité de leurs données.
À retenir
- Une donnée de mauvaise qualité n’arrête pas l’entreprise, mais elle coûte en retraitements, contrôles et confiance.
- Chaque référentiel stratégique doit avoir un système maître clairement identifié.
- Rendre un champ obligatoire ne suffit pas : les utilisateurs doivent comprendre à quoi il sert.
- Les valeurs obsolètes doivent disparaître ou être remappées rapidement, sans tables de correspondance qui s’éternisent.
- La fréquence de mise à jour s’adapte aux usages : le temps réel partout coûte sans bénéfice.
- Beaucoup de « problèmes de reporting » sont en réalité des problèmes de qualité de données.